

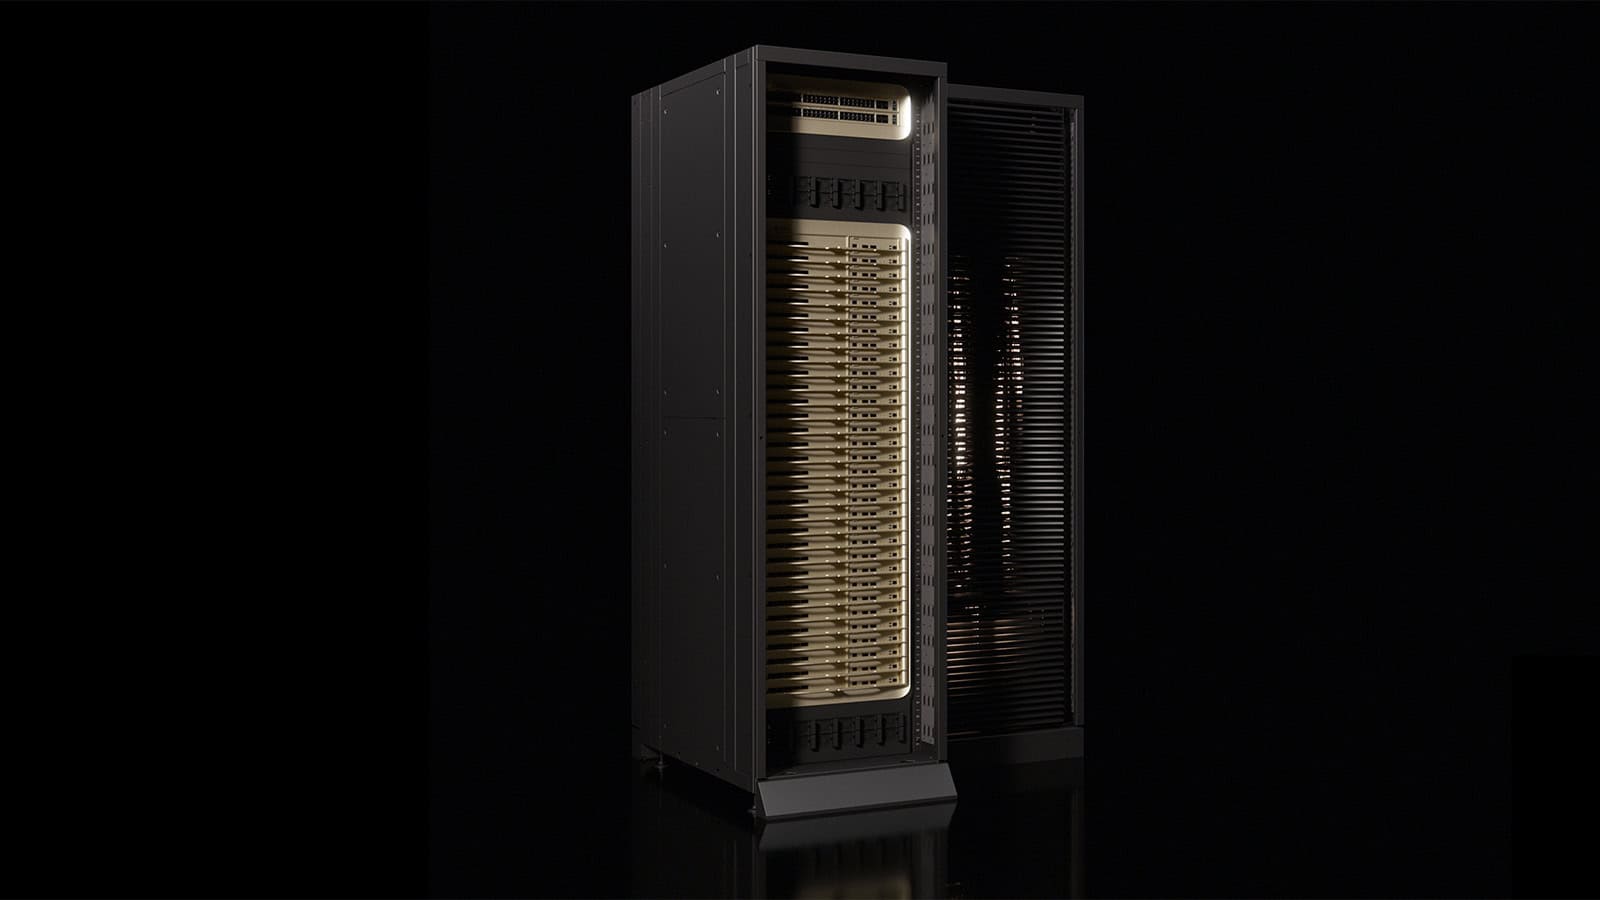
Prévia: A Nvidia inicia a produção do rack Groq 3 LPX, prometendo respostas mais rápidas em sistemas de inteligência artificial. A tecnologia, adquirida por US$ 20 bilhões, visa melhorar a inferência de baixa latência em aplicações críticas.
A Nvidia deu um passo significativo ao colocar o rack Groq 3 LPX em produção, com previsão de operação na neocloud Nebius ainda este ano. Essa inovação surge após a aquisição de ativos da Groq, que custou à empresa cerca de US$ 20 bilhões, a maior compra já realizada pela Nvidia.
O foco principal dessa nova tecnologia é a inferência de baixa latência, um aspecto crucial em aplicações onde a rapidez de resposta é essencial. Em cenários de programação, por exemplo, atrasos podem impactar negativamente a experiência do usuário, tornando essa inovação ainda mais relevante.
Groq ganha espaço nos data centers
Na Nebius, os racks Groq 3 LPX serão integrados com processadores Vera e GPUs Rubin. Dion Harris, diretor sênior da Nvidia, confirmou que esses equipamentos estarão disponíveis ainda este ano, ampliando as capacidades da empresa em oferecer soluções de IA mais rápidas e eficientes.
A arquitetura do Groq 3 LPX se destaca por incluir 500 MB de memória SRAM de alta velocidade diretamente no chip, o que visa minimizar os gargalos comuns durante a execução de modelos de IA. Cada rack é composto por 256 chips Groq 3, que, segundo a Nvidia, podem processar até 3.400 tokens por segundo, conforme um benchmark realizado pela Artificial Analysis.
Os principais números do Groq 3 LPX:
- Cada rack Groq 3 LPX reúne 256 chips Groq 3;
- O sistema chega a 3.400 tokens por segundo;
- A arquitetura conta com 500 MB de SRAM integrada ao chip;
- A tecnologia prioriza a inferência de baixa latência;
- A Nvidia pagou US$ 20 bilhões pelos ativos da Groq.
Não é uma substituição das GPUs
É importante destacar que a tecnologia da Groq não tem como objetivo substituir as GPUs, mas sim complementar suas funções. Os chips Groq são especializados na etapa de “decode” da inferência, que é responsável pela geração dos tokens que formam as respostas dos modelos de IA.
As GPUs continuam a desempenhar um papel crucial no treinamento e na inferência, oferecendo maior flexibilidade para lidar com diferentes modelos e tecnologias. Harris enfatiza que a estratégia da Nvidia é utilizar a tecnologia mais adequada para cada parte da carga de trabalho, sem eliminar uma em detrimento da outra.
Corrida pela menor latência
A Nvidia não está sozinha nessa corrida por respostas mais rápidas. A AMD também anunciou planos de integrar seus sistemas a chips da Cerebras, enquanto a OpenAI apresenta seu modo Ultrafast, que promete 750 tokens por segundo, alimentado pela mesma tecnologia da Cerebras.
Enquanto isso, a Nvidia continua a expandir a produção dos sistemas Vera Rubin, que foram apresentados anteriormente. Durante um evento em março, Jensen Huang, CEO da Nvidia, mencionou que um quarto do espaço dos data centers seria dedicado aos chips Groq, enquanto o restante seria ocupado pelos sistemas Vera Rubin.
Com a introdução da Groq, a Nvidia diversifica suas opções para acelerar a inferência em IA, mantendo as GPUs como a base de seus sistemas. Essa nova abordagem visa atender à demanda crescente por respostas rápidas e eficientes em um mercado cada vez mais competitivo.









